

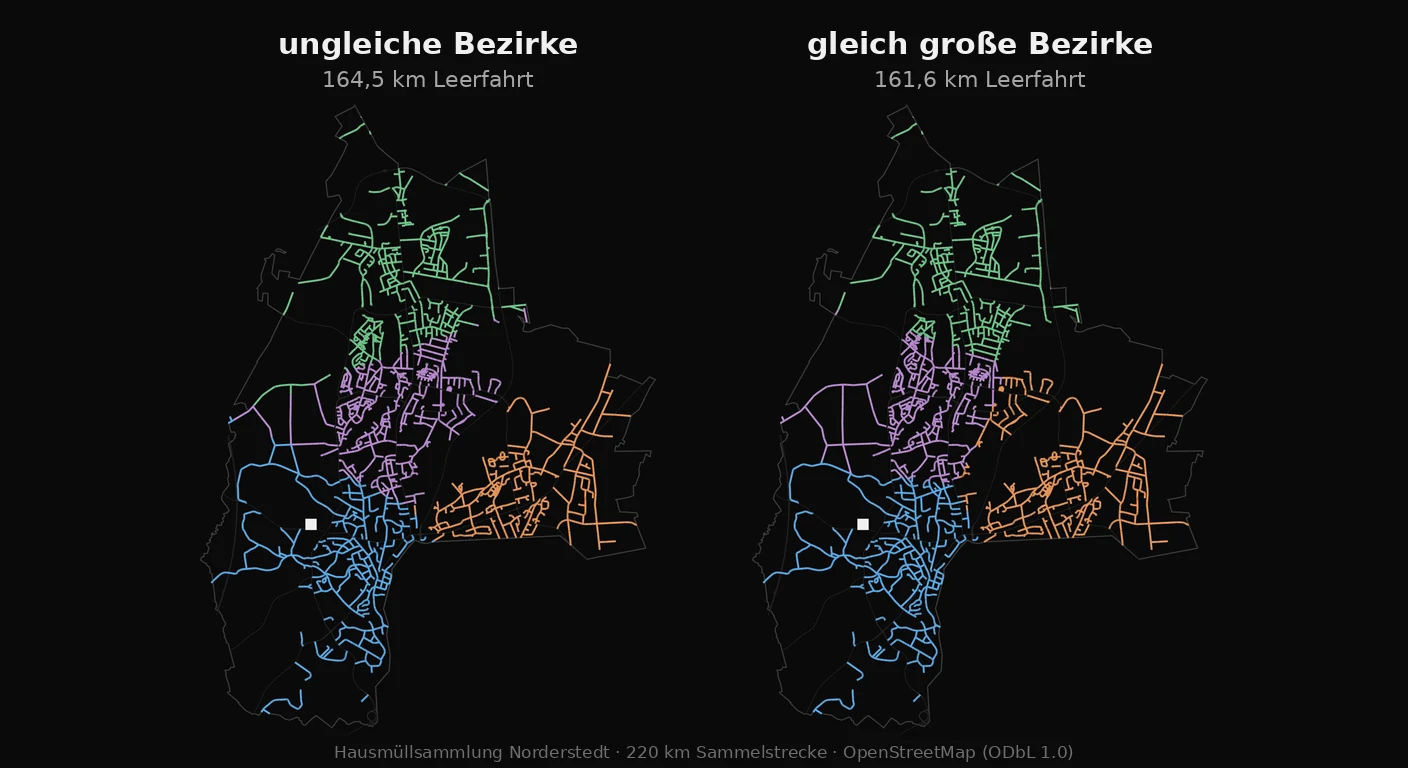
Wenn in einer Ausschreibung für Sammeltouren „gleichmäßig ausgelastete Bezirke" gefordert wird, klingt das nach einer harmlosen Nebenbedingung. Wir wollten wissen, was sie tatsächlich kostet – und haben eine ganze Stadt durchgerechnet, auf Daten, die jeder nachrechnen kann.
Das Ergebnis hat uns überrascht, und zwar zweimal. Beim ersten Mal falsch.
Warum Müllabfuhr kein normales Tourenproblem ist
Ein Lieferfahrzeug fährt Punkte an. Die Frage ist, in welcher Reihenfolge – das klassische Vehicle Routing Problem.
Ein Sammelfahrzeug fährt Straßenzüge ab. Jede Wohnstraße muss einmal befahren werden, weil an jedem Haus etwas steht. Gesucht ist nicht die Reihenfolge von Stopps, sondern ein möglichst kurzer geschlossener Weg, der jede Sammelstraße mindestens einmal enthält. In der Fachsprache: ein Arc-Routing-Problem statt eines Node-Routing-Problems.
Der Unterschied klingt akademisch und ist in der Praxis der Grund, warum manche Planungswerkzeuge für Entsorgung schlicht nicht taugen. Wer Sammelstraßen als Punktliste modelliert, rechnet die falsche Aufgabe.
Das Gebiet
Norderstedt, rund 80.000 Einwohner, 58,05 km² Stadtfläche, eigener kommunaler Betrieb. Für uns die Nachbarstadt – und bewusst kein Kunde und kein Zielkonto, dazu unten mehr.
Aus den offenen OpenStreetMap-Daten ergeben sich 220,2 Kilometer Sammelstrecke: alle Wohn-, Anlieger- und Erschließungsstraßen im Stadtgebiet, zusammengesetzt aus 9.308 Straßenabschnitten. Als Startpunkt dient der dort verzeichnete Bauhof am Wertstoffhof.
Diese 220 Kilometer sind gesetzt. Keine Software verkleinert sie, weil jedes Haus angefahren werden muss. Planbar ist nur, was dazwischen passiert: die Leerfahrt – Anfahrt zum Bezirk, Wechsel zwischen Straßenzügen, Rückweg zum Hof.
Das ist die einzige ehrliche Kennzahl für Tourenplanung. Wer mit Gesamtkilometern wirbt, verkauft Ihnen die Geografie als eigene Leistung.
Vier Aufteilungen, ein Rechner
Wir haben die 220 Kilometer auf vier Bezirke verteilt – vier Sammeltage – und vier Aufteilungen mit identischem Tourenverfahren gerechnet. Die Sammelstrecke ist überall gleich; verglichen wird ausschließlich die Leerfahrt.
| Variante | Wie die Bezirke zustande kommen | Spanne je Bezirk | Leerfahrt | Gesamtweg |
|---|---|---|---|---|
| D | gleiche Last, kompakt zugeteilt | 54,8–55,3 km · 1 % | 161,6 km | 381,8 km |
| A | Nähe zu den vier Stadtteilzentren | 46,4–60,6 km · 31 % | 164,5 km | 384,8 km |
| C | gleiche Last, harte Obergrenze, Netzentfernung | 50,1–56,7 km · 13 % | 174,6 km | 394,8 km |
| B | gleiche Last, harte Obergrenze, Luftlinie | 50,1–56,7 km · 13 % | 186,1 km | 406,3 km |
B, C und D verfolgen dasselbe Ziel. Vier gleich ausgelastete Bezirke, nicht mehr und nicht weniger. Zwischen ihnen liegen 24,5 Kilometer Leerfahrt – bei jedem Sammelzyklus aufs Neue.
Und die gleichmäßigste Aufteilung ist zugleich die kürzeste. Variante D verteilt die Last auf ein Prozent genau und fährt trotzdem am wenigsten leer.
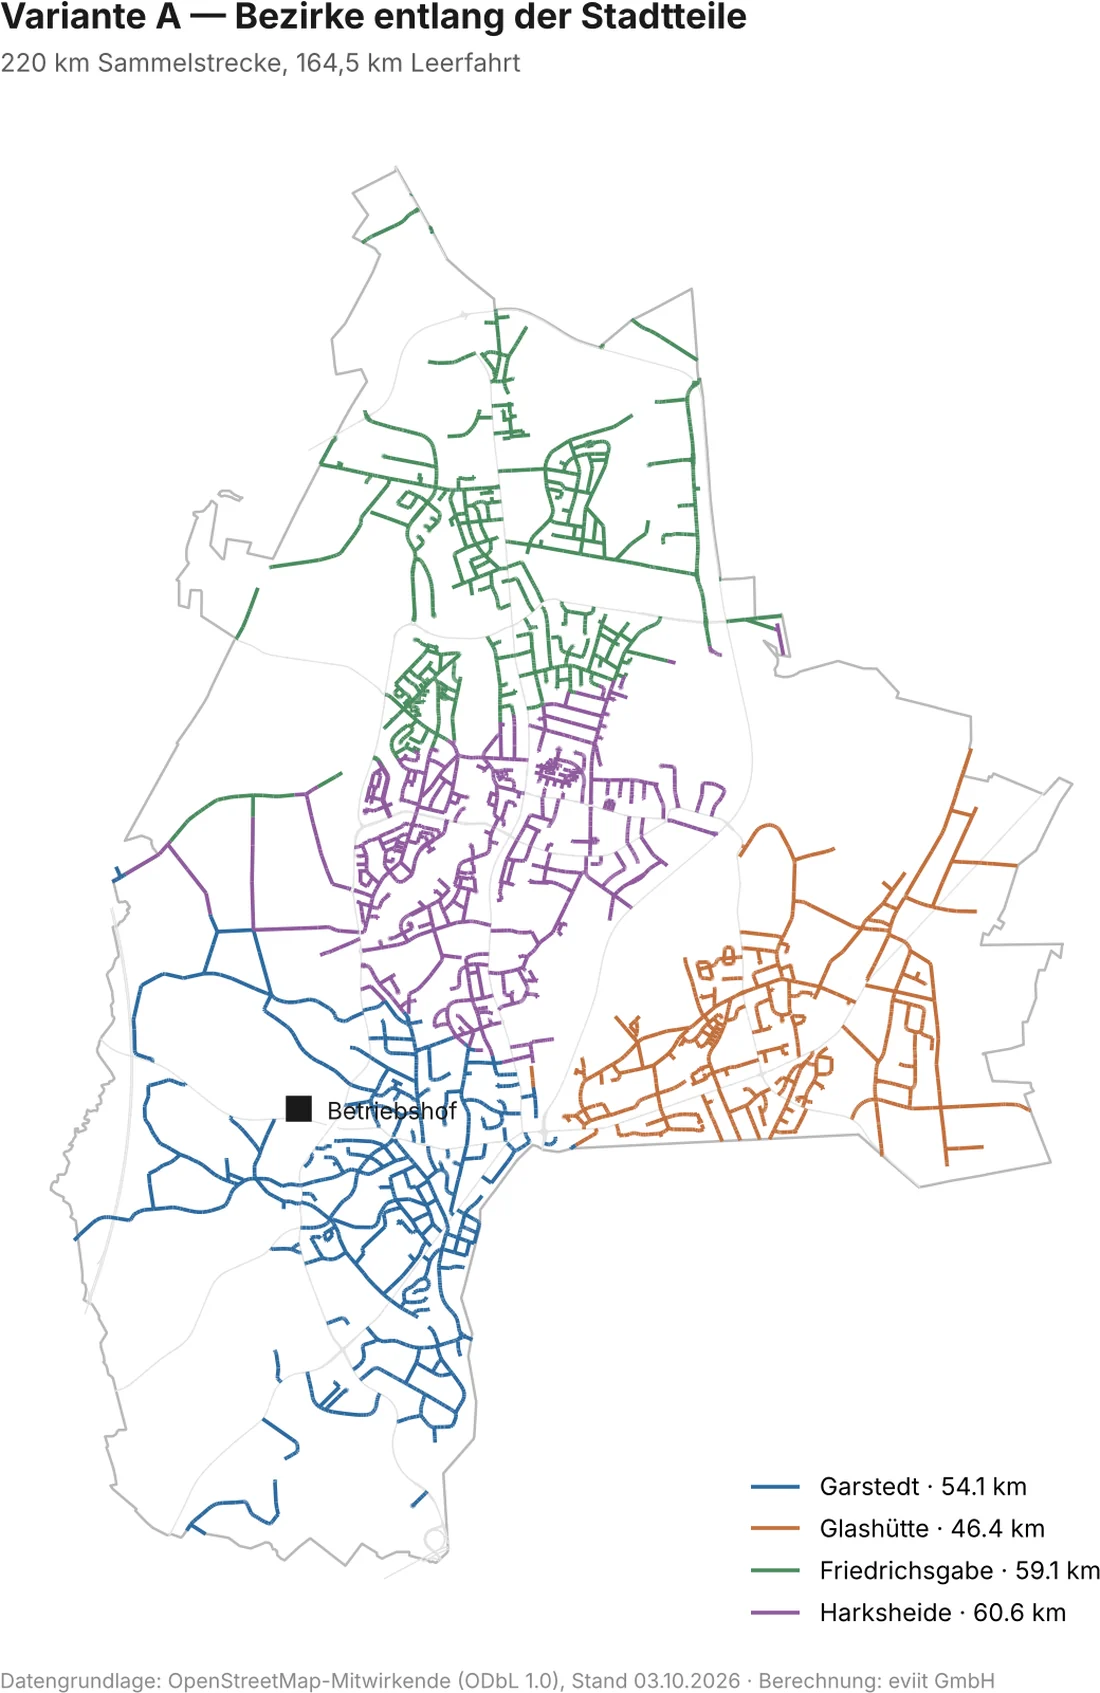
Variante A ist kompakt, aber ungleich: Der größte Bezirk trägt ein Drittel mehr Sammelstrecke als der kleinste. Wer so plant, bekommt kurze Wege und ungleiche Schichten.
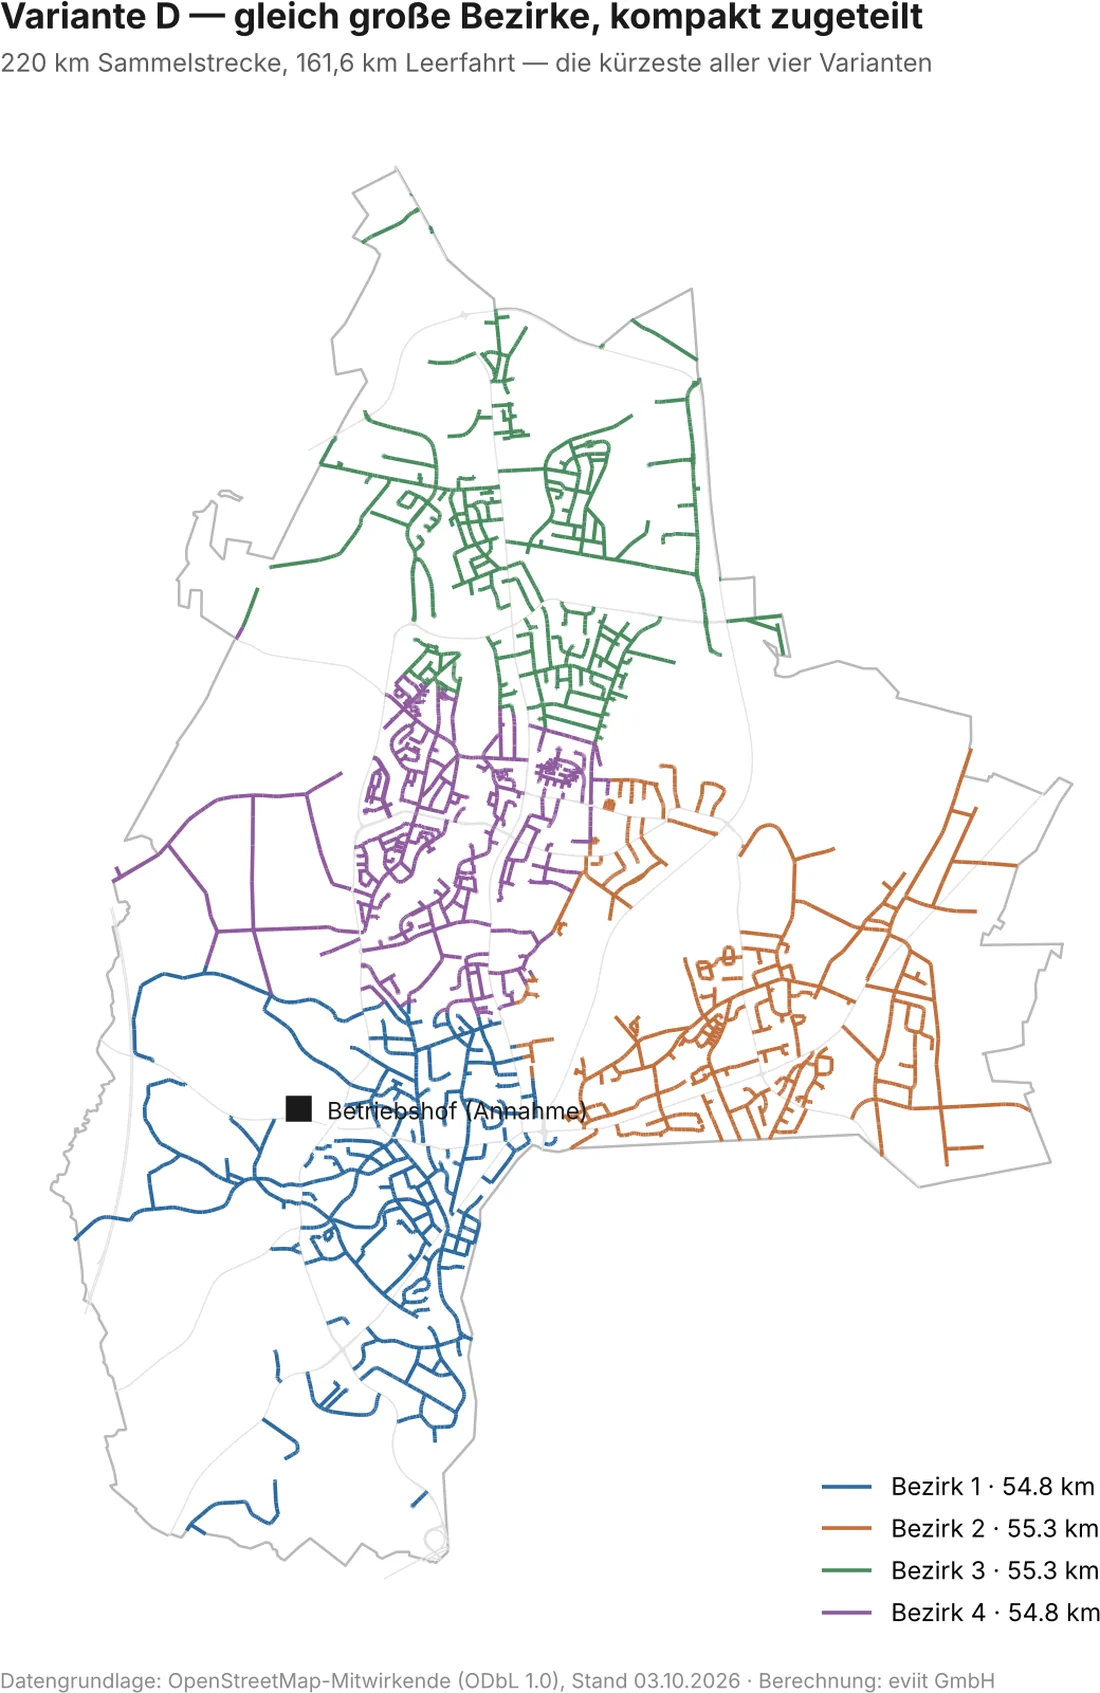
Zur Einordnung: Eine einzige Tour über das gesamte Stadtgebiet, ohne jede Bezirksteilung, käme mit 122,4 Kilometern Leerfahrt aus. Die Aufteilung in vier Tagesbezirke kostet also rund 39 Kilometer, überwiegend Hin- und Rückwege zum Hof. Diese eine Tour wäre mit 343 Kilometern an einem Tag nicht fahrbar – sie ist keine Alternative, sondern ein Maßstab.
Der Fehler, der fast in diesem Beitrag gestanden hätte
Unser erster Durchlauf umfasste nur A, B und C. Das Bild war eindeutig: Die lastbalancierten Varianten fuhren mehr leer als die ungleichen, gewachsenen Bezirke. Die Schlussfolgerung schrieb sich von selbst – Gleichmäßigkeit kostet Fahrstrecke, und wer sie will, muss den Preis kennen.
Wir haben den Befund sogar geprüft: dieselbe Rechnung mit fünf zufälligen Startpunkten. Die Leerfahrt lag jedes Mal zwischen 169 und 178 Kilometern, in jedem einzelnen Lauf schlechter als die ungleichen Bezirke. Robust, dachten wir.
Er war trotzdem falsch.
Die Prüfung hat nur bestätigt, dass dasselbe schwache Zuteilungsverfahren bei jedem Startpunkt schwach bleibt. B und C waren nie lastbalanciert – sie waren kappengesättigt. Das Verfahren füllt Bezirke nach Abstand sortiert bis zu einer harten Obergrenze. Drei Bezirke liefen exakt auf diese Grenze, der vierte bekam den Rest. Straßen am Rand landeten dort, wo noch Platz war, statt dort, wo sie hingehören.
Messbar wird das am größten Abstand einer Sammelstraße zum Schwerpunkt ihres Bezirks: 3,8 Kilometer in Variante A, bis zu 6,8 Kilometer in B und C – und 3,4 Kilometer in D.
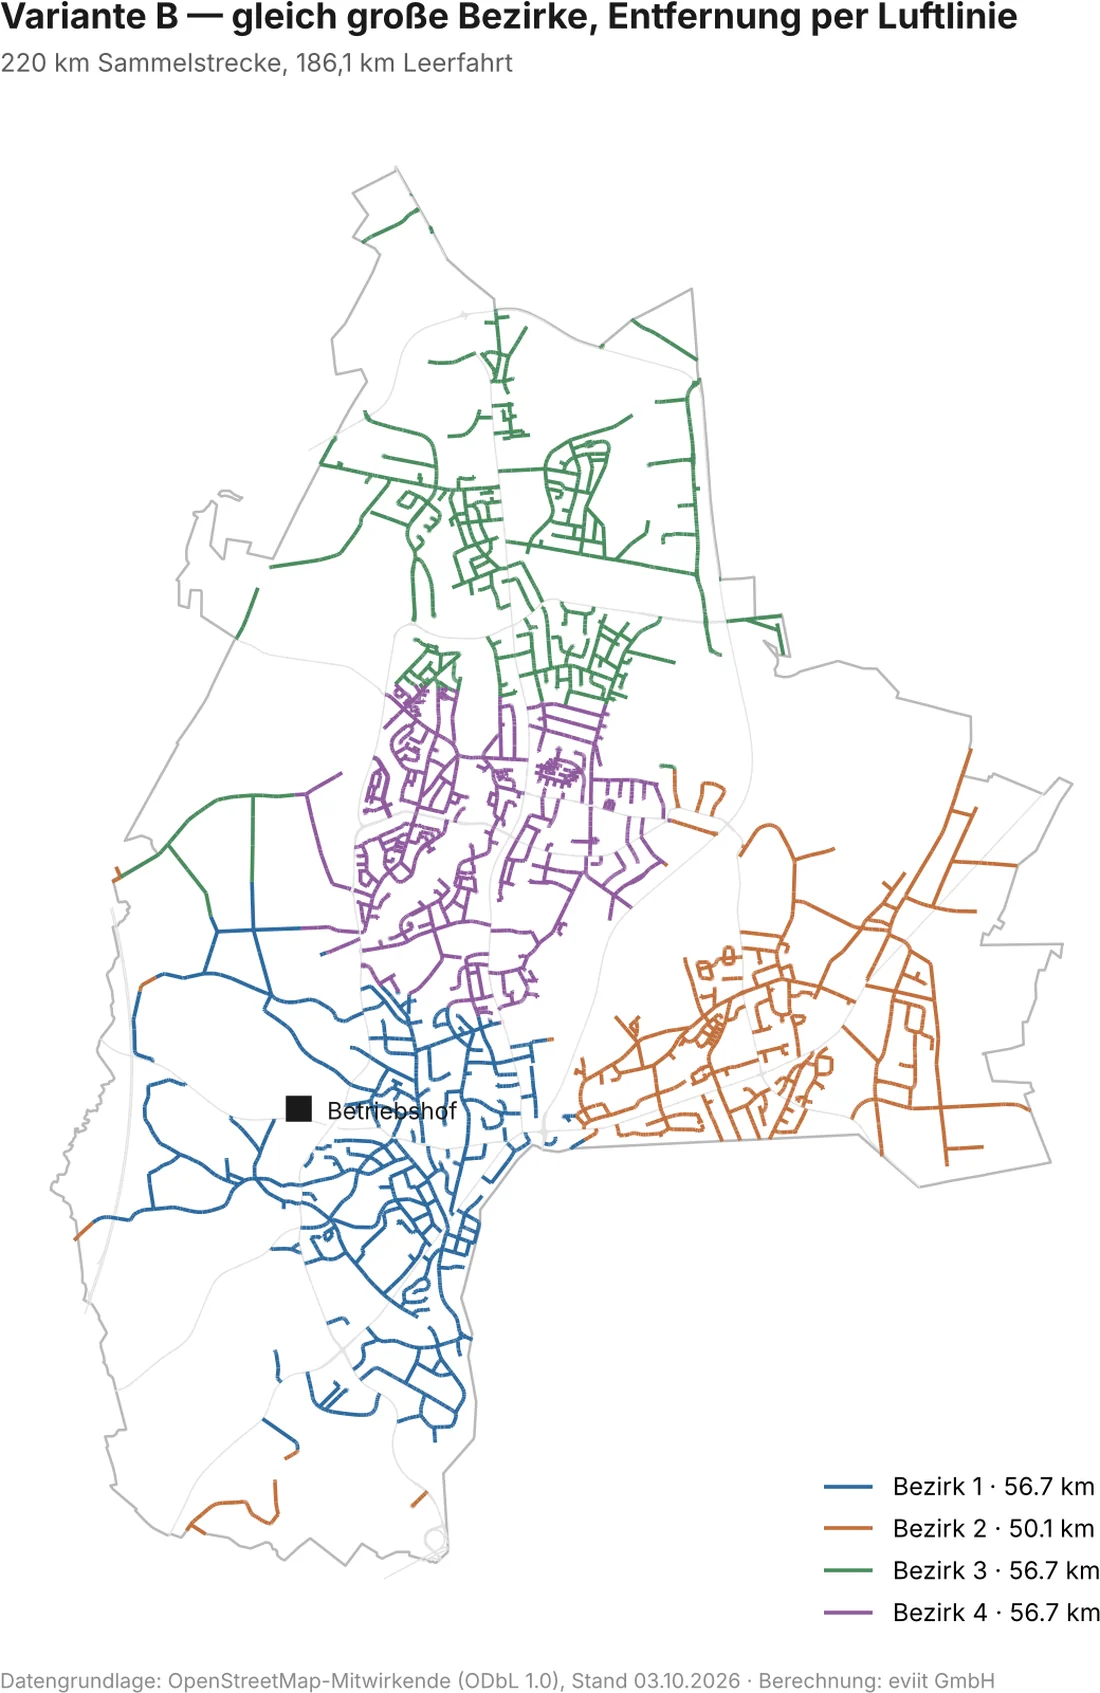
Erst die Gegenprobe mit einem zweiten, unabhängigen Zuteilungsverfahren hat das sichtbar gemacht und die Schlussfolgerung umgedreht.
Wir schreiben das hier hin, weil es der nützlichste Teil ist. Eine Optimierung liefert immer ein Ergebnis. Ob es etwas über die Wirklichkeit sagt oder nur über den eingesetzten Algorithmus, sieht man ihm nicht an – und ein Vergleich gegen eine zweite, bessere Methode ist der einzige Weg, das auseinanderzuhalten. Genau diese Gegenprobe fehlt in den meisten Optimierungsergebnissen, die wir zu sehen bekommen.
Drei Lehren
Das Ziel sagt nichts über das Ergebnis. Zwischen drei Verfahren mit identischem Ziel liegen 24,5 Kilometer. Wer eine Tourenplanung danach beurteilt, was sie anstrebt, hat noch nichts beurteilt. Entscheidend ist, wie zugeteilt wird: ob ein Verfahren Kompaktheit und Auslastung gegeneinander abwägt – oder ob es Bezirke der Reihe nach bis zu einer Obergrenze füllt und den Rest irgendwo unterbringt.
Luftlinie ist nicht Entfernung. B und C unterscheiden sich allein darin, wie Nähe gemessen wird: Luftlinie gegen tatsächliche Entfernung im Straßennetz. Das kostet 11,4 Kilometer. Jede Bezirkseinteilung, die auf einer Karte mit dem Lineal oder in einer Tabelle nach Postleitzahlen entsteht, macht genau diesen Fehler. Autobahnen, Bahntrassen und Flüsse trennen Gebiete, die auf der Karte nebeneinanderliegen – eine der Restriktionen, die in keiner Entfernungsmatrix aus Koordinaten auftaucht.
Die Zahl, die zählt, ist die Leerfahrt. 220 der 382 Kilometer sind Sammelstrecke und nicht verhandelbar. Wer eine Einsparung auf die Gesamtkilometer bezieht, rechnet sich klein; wer sie auf die Leerfahrt bezieht, sagt, was planerisch passiert ist. Die 24,5 Kilometer zwischen D und B sind 13 Prozent der Leerfahrt, aber nur 6 Prozent des Gesamtwegs. Dieselbe Maßnahme, zwei Prozentzahlen – und nur eine davon beschreibt die Planung.
Was wir ausdrücklich nicht behaupten
Dies sagt nichts über die tatsächlichen Touren der Stadt Norderstedt. Sie sind nicht veröffentlicht, wir kennen sie nicht, und wir haben nicht gefragt. Alle vier Varianten sind unsere eigenen Modelle und nur untereinander vergleichbar. Variante A ist auch nicht die amtliche Stadtteilgliederung – amtliche Grenzen liegen in OpenStreetMap nicht vor, wir haben nach Nähe zu den vier dort verzeichneten Ortsteilpunkten geteilt. Der Betriebshof ist eine plausible Annahme, kein bestätigter Startpunkt.
Das Modell ist bewusst schlank. Gerechnet wird reine Fahrstrecke. Nicht enthalten sind Behälterzahlen, Haltezeiten, Fahrzeugkapazität, Zwischenfahrten zur Verwertungsanlage und Schichtlängen. Einbahnstraßen stecken in den Daten, werden aber nicht erzwungen – 11,8 Kilometer der Sammelstrecke sind Einbahnstraßen, die Leerfahrt ist dadurch eher zu niedrig. Jede Straße wird genau einmal befahren; breitere Straßen, die real je Seite gesammelt werden, wären doppelt zu zählen. Stichwege sind ausgeschlossen. Die 220 Kilometer sind damit eine Untergrenze.
Die Lösungen sind gut, nicht beweisbar optimal. Das Verfahren verbindet die Pflichtkanten, paart anschließend die Knoten ungerader Ordnung und bildet daraus eine geschlossene Tour. Die Paarung lösen wir exakt über ein Blossom-Matching – das war über alle 16 gerechneten Bezirke hinweg 19 bis 32 Prozent besser als eine naheliegende gierige Paarung. Auch das ein Beleg dafür, dass die Methode die Zahl macht, nicht das Ziel. Entscheidend für diesen Vergleich ist, dass alle vier Varianten mit identischem Code gerechnet wurden.
Nachrechnen
Der vollständige Code liegt öffentlich auf GitHub, zusammen mit den Karten und den Ergebnissen: github.com/eviit-GmbH/norderstedt-arc-routing. Datengrundlage ist ausschließlich OpenStreetMap. Ein Durchlauf dauert auf einem normalen Rechner rund sieben Minuten und reproduziert jede Zahl aus diesem Beitrag.
Falls Sie die Rechnung für Ihr eigenes Gebiet sehen wollen – eine Sammlung, einen Werkverkehr, einen Servicebereich: Wie viel Ihrer Fahrstrecke überhaupt planbar ist, lässt sich mit vier Wochen Tourdaten beantworten. Wie wir dabei vorgehen, steht im Tourenoptimierungs-Check.
Welche Verfahren hinter solchen Rechnungen stecken und wann welches trägt, ordnet der Überblick Verfahren der Tourenoptimierung ein. Warum eine alte Heuristik als Vergleichsmaßstab oft reicht, zeigt der Beitrag zum Savings-Algorithmus. Für Aufgaben, die kein Standardwerkzeug abdeckt, bauen wir individuelle Routing-Lösungen.
Quellen
- OpenStreetMap-Mitwirkende: Straßennetz, Stadtgrenze, Ortsteile und Betriebshof. Extrakt Schleswig-Holstein der Geofabrik, Stand 3. Oktober 2026. Lizenz ODbL 1.0. download.geofabrik.de
- eviit GmbH: Rechencode und Ergebnisse, MIT-Lizenz. github.com/eviit-GmbH/norderstedt-arc-routing
- Edmonds, J. (1965): Paths, Trees, and Flowers. Canadian Journal of Mathematics 17, S. 449–467. doi.org/10.4153/CJM-1965-045-4 – das Matching-Verfahren hinter Schritt 3
- Eiselt, H. A.; Gendreau, M.; Laporte, G. (1995): Arc Routing Problems, Part II: The Rural Postman Problem. Operations Research 43(3), S. 399–414. doi.org/10.1287/opre.43.3.399
- Längenmaße in ETRS89 / UTM Zone 32N (EPSG:25832)